Resiliencia en Node.js: timeouts, fallback, bulkhead y health checks en un backend real
Resiliencia en Node.js con timeouts, fallback, graceful degradation, bulkhead, health checks y graceful shutdown, con ejemplos en TypeScript. Guía práctica.
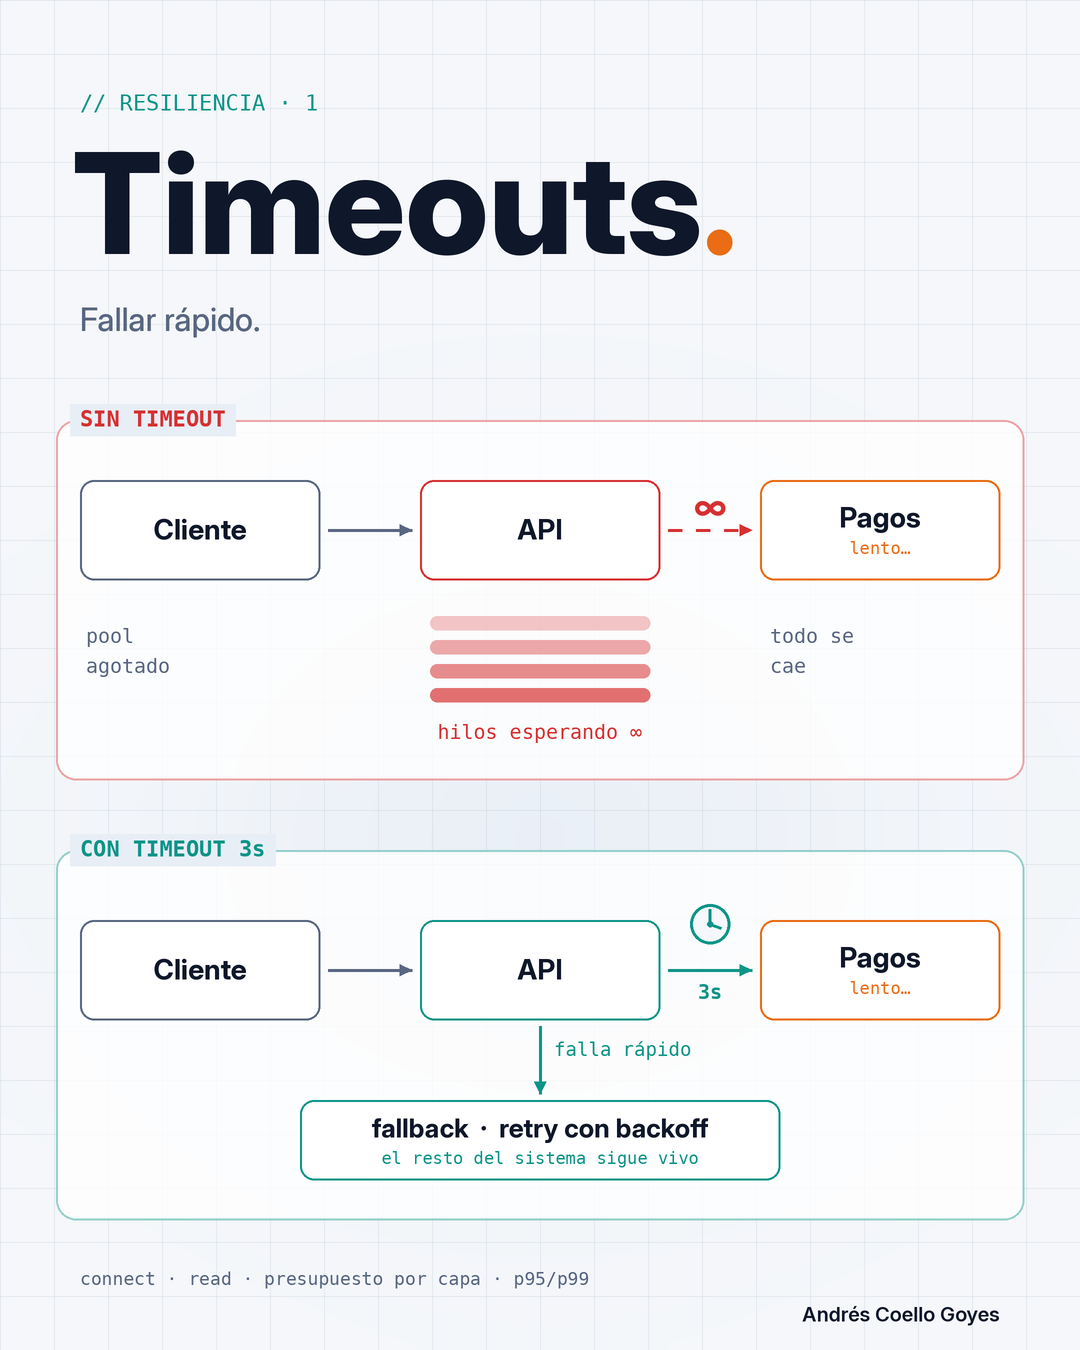
Durante cinco lunes publiqué en LinkedIn una serie corta sobre resiliencia en backend. Cada post tenía que caber en una pantalla, así que muchas cosas quedaron afuera. Este artículo junta todo en un solo lugar, con más contexto, ejemplos en TypeScript un poco más completos y los errores que más se repiten.
Antes de esta serie ya había escrito en LinkedIn sobre Retry vs Circuit Breaker y sobre Dead Letter Queues. Aquí los menciono cuando hacen falta, pero no los vuelvo a explicar desde cero.
La idea general es simple. Un sistema que depende de otros servicios va a ver fallos, y lo que importa es que un fallo pequeño no termine tumbando todo. Los cinco patrones de este artículo atacan eso desde lugares distintos.
1. Timeouts
Por qué importa
Imagina un viernes en hora pico. El proveedor de pagos sigue arriba, pero empieza a responder lento. Cada request que llega a tu API se queda esperando la respuesta del proveedor. Se acaban las conexiones del pool, sube la memoria, los usuarios vuelven a darle clic y hasta los endpoints que no tienen nada que ver con pagos empiezan a fallar.
Ningún servicio se cayó, pero una sola dependencia lenta bastó para que todo dejara de responder.
Un timeout es decidir cuánto tiempo vale la pena esperar antes de cortar. Parece obvio, pero muchas librerías HTTP y drivers de base de datos traen el timeout desactivado o con valores enormes por defecto. Si nunca lo configuraste, lo más probable es que estés usando uno de esos.
Connect y read son distintos
El connect timeout es lo que esperas para abrir la conexión. Debería ser corto, porque si un servidor no acepta la conexión rápido, casi nunca la va a aceptar después. El read timeout es lo que esperas por la respuesta una vez conectado, y ahí sí depende de lo que haga el servicio.
Con fetch en Node.js no tienes los dos por separado, tienes un límite total. Si necesitas controlarlos por separado, librerías como undici te dejan configurar connectTimeout y bodyTimeout.
Un presupuesto para toda la cadena
Si el cliente corta a los 5 segundos, no tiene sentido que el gateway espere 10 y el servicio 30 a la base de datos. Cuando el cliente ya se fue, tu backend sigue trabajando para nadie y ocupando recursos que otra request necesita.
La regla que sigo es que cada capa espera menos que la anterior. Y si puedes, propaga el tiempo que queda. Si una request entra con 5 segundos de presupuesto y ya gastaste 2, la llamada siguiente no debería tener más de 3.
Cómo elegir el valor
El número sale de las métricas. Revisa el p95 o p99 de latencia de esa dependencia y pon el timeout un poco por encima. Si lo pones muy bajo, cortas respuestas que iban a llegar bien. Si lo pones muy alto, no te protege de nada.
Ejemplo
const PAYMENTS_TIMEOUT_MS = 3000;

export async function chargePayment(payload: ChargeRequest, parent?: AbortSignal) {
  const signals = [AbortSignal.timeout(PAYMENTS_TIMEOUT_MS)];
  if (parent) signals.push(parent);

  const res = await fetch(`${process.env.PAYMENTS_URL}/charges`, {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify(payload),
    signal: AbortSignal.any(signals),
  });

  if (!res.ok) throw new Error(`payments respondió ${res.status}`);
  return res.json();
}
AbortSignal.any combina el timeout propio con la señal de la request original. Si el usuario cierra la conexión, también se cancela la llamada al proveedor. Está disponible desde Node.js 20.3.
Errores comunes
- Confiar en el valor por defecto de la librería sin revisarlo.
- Poner el mismo timeout en todas las capas, o uno más largo abajo que arriba.
- Configurar timeout en HTTP pero olvidarse de la base de datos, Redis o la cola.
- Elegir el número a ojo y nunca volver a revisarlo.
Cómo se conecta con retry y circuit breaker
Sin timeout, el retry no se entera de que un intento falló, porque el intento nunca termina. Y el circuit breaker no tiene fallos que contar para abrirse. Los dos patrones que vimos en LinkedIn en el post de Retry vs Circuit Breaker dependen de que primero exista un timeout.
2. Fallback
Por qué importa
Entras a la página de un producto en una tienda online. Abajo debería aparecer "Te puede interesar", pero el servicio de recomendaciones está caído. Si nadie pensó en ese caso, la página entera devuelve un 500 y el usuario se va sin ver el precio.
Lo curioso es que el producto, el precio y el botón de comprar estaban bien. Lo único roto era una sección secundaria.
Un fallback es la respuesta que ya tienes preparada para cuando una dependencia no contesta, ya sea porque falló, porque la cortaste por timeout o porque el circuit breaker está abierto.
Tipos de fallback
- Último valor bueno en caché. Sirve para datos que pueden estar un poco viejos, como recomendaciones, configuraciones o tasas que cambian poco.
- Valor por defecto. Si la API de envíos no responde, puedes mostrar "el costo de envío se calcula al pagar".
- Proveedor alternativo. Tiene sentido para correo, SMS o notificaciones, donde existen varios proveedores intercambiables.
- Ocultar la sección. La página sigue funcionando sin ese bloque.
- Encolar para después. Si no puedes procesar algo ahora, lo guardas en una cola y lo procesas cuando el servicio vuelva. Si sigue fallando, termina en una DLQ, como conté en LinkedIn en el post sobre Dead Letter Queues.
Ejemplo
const FALLBACK_KEY = 'recs:mas-vendidos';

export async function getRecommendations(productId: string): Promise<Product[]> {
  try {
    const res = await fetch(`${process.env.RECS_URL}/products/${productId}`, {
      signal: AbortSignal.timeout(800),
    });
    if (!res.ok) throw new Error(`recs respondió ${res.status}`);
    const items: Product[] = await res.json();
    await cache.set(`recs:${productId}`, items, { ttlSeconds: 3600 });
    return items;
  } catch (err) {
    metrics.increment('fallback.recommendations');
    logger.warn({ err, productId }, 'usando fallback de recomendaciones');

    const lastGood = await cache.get<Product[]>(`recs:${productId}`);
    return lastGood ?? (await cache.get<Product[]>(FALLBACK_KEY)) ?? [];
  }
}
El orden es el último resultado bueno para ese producto, después los más vendidos y, si tampoco hay, una lista vacía para que el front oculte la sección.
Cuándo no usar fallback
No todo se arregla con un plan B. Si falla el cobro de una tarjeta o la consulta de un saldo, no inventes una respuesta. Mostrar "pago exitoso" cuando no lo fue es mucho peor que mostrar un error. En esos casos lo correcto es decirle la verdad al usuario y pedirle que lo intente más tarde.
Una pregunta que me hago antes de poner un fallback es qué pasa si el usuario toma una decisión con ese dato. Si la respuesta es "pierde plata" o "hace algo que no puede deshacer", no hay fallback.
Errores comunes
- No registrar cuándo se activa. Sin una métrica puedes pasar semanas sirviendo caché vieja sin enterarte de que el servicio nunca volvió.
- Un fallback que llama a otra dependencia igual de frágil, sin timeout propio.
- Fallback en operaciones de escritura donde el usuario cree que algo se guardó y no fue así.
3. Graceful degradation
Por qué importa
El fallback resuelve una dependencia. Graceful degradation es el mismo razonamiento llevado a todo el sistema, para cuando hay demasiada carga o se cae una parte grande.
Piensa en un Black Friday. El tráfico se dispara, la base de datos va al límite y todo empieza a tardar. Si todo sigue prendido, lo más probable es que el checkout se caiga junto con las reseñas, y el checkout es lo único que de verdad importa ese día.
Esencial y opcional
El trabajo de verdad es hacer una lista antes de que pase algo. En una tienda se podría ver así.
Esencial: catálogo, carrito, checkout y pagos.
Opcional: recomendaciones, reseñas, contador de stock en tiempo real y filtros pesados de búsqueda.
Lo opcional se apaga primero. Los filtros pueden quedar en una búsqueda simple, el stock puede decir "disponible" en vez del número exacto y las reseñas pueden esperar.
Esa lista se arma con el equipo de producto, no solo con backend. En medio de un incidente nadie quiere discutir si las reseñas son importantes.
Feature flags y kill switches
Para apagar algo sin desplegar de nuevo necesitas un interruptor que se pueda cambiar en caliente. Puede ser un servicio de feature flags o algo más simple, como un valor en Redis que tu app revisa.
type DegradableFeature = 'reviews' | 'recommendations' | 'live-stock' | 'advanced-search';

export async function isEnabled(feature: DegradableFeature): Promise<boolean> {
  const value = await redis.get(`killswitch:${feature}`);
  return value !== 'off';
}

app.get('/products/:id/reviews', async (req, res) => {
  if (!(await isEnabled('reviews'))) {
    return res.json({ items: [], degraded: true, message: 'Las reseñas vuelven en unos minutos.' });
  }
  res.json({ items: await reviewsService.list(req.params.id) });
});
El campo degraded le permite al front mostrar un mensaje en lugar de una sección vacía sin explicación.
Modo de solo lectura
Otra opción es un modo de solo lectura. Si la base de datos principal tiene problemas pero las réplicas de lectura siguen bien, la gente puede seguir navegando aunque no pueda comentar ni editar su perfil. Es mejor que tener la tienda completamente caída.
Errores comunes
- Apagar cosas en silencio. Si la búsqueda está limitada, avísale al usuario con un mensaje corto.
- Tener los kill switches pero nunca haberlos probado. El día que los necesitas descubres que el front explota cuando la API devuelve una lista vacía.
- Que el propio sistema de feature flags sea un punto único de falla. Si no responde, la app debería asumir un valor por defecto razonable.
4. Bulkhead
Por qué importa
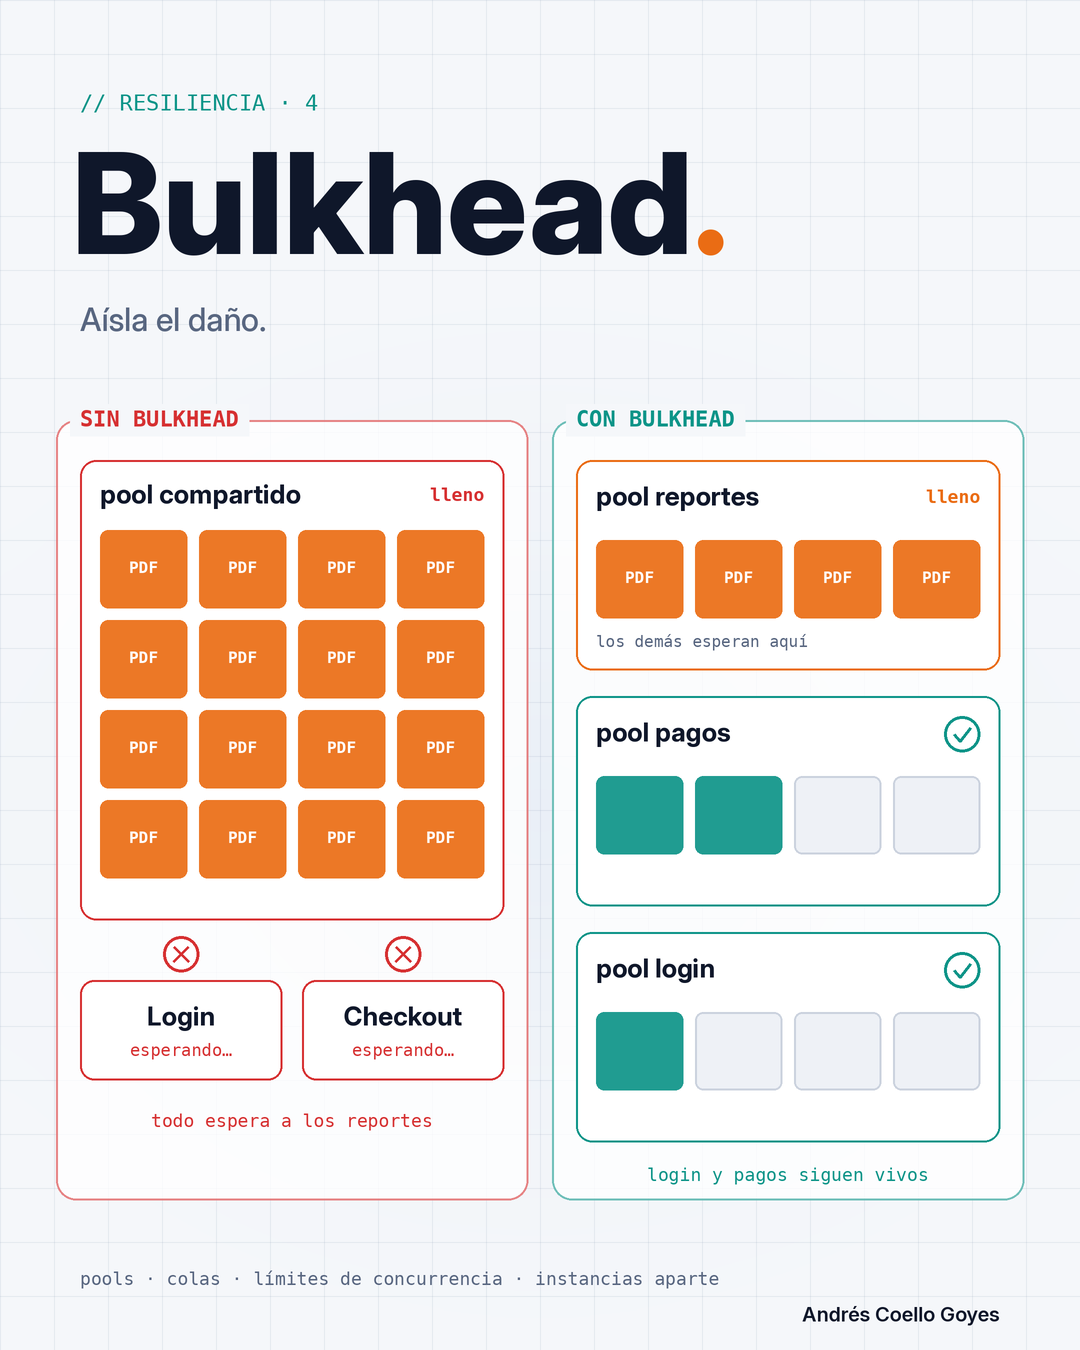
Varios usuarios piden a la vez un reporte en PDF de todo el año. Cada uno tarda un buen rato y ocupa una conexión a la base de datos mientras se genera. Al poco tiempo el pool está lleno de reportes, y cuando alguien intenta iniciar sesión o pagar se queda esperando una conexión que no se libera.
Los reportes no fallaron. Se comieron los recursos que todos compartían.
El nombre viene de los barcos. El casco se divide en compartimentos para que, si entra agua en uno, no se hunda el barco completo. En backend la idea es separar recursos por tipo de trabajo o por dependencia, para que lo pesado no deje sin aire a lo crítico.
Formas de aplicarlo
- Un pool de conexiones aparte para el trabajo pesado, con un límite bajo.
- Colas y workers separados para reportes, exportaciones o procesamiento de archivos.
- Límites de llamadas simultáneas a cada proveedor lento.
- Instancias aparte para los jobs pesados, para que no compitan por CPU y memoria con la API.
Ejemplo con pools separados y p-limit
import { Pool } from 'pg';
import pLimit from 'p-limit';

// Pool principal para login, checkout y el resto del tráfico normal
export const mainPool = new Pool({ connectionString: process.env.DATABASE_URL, max: 20 });

// Pool pequeño solo para reportes
export const reportsPool = new Pool({ connectionString: process.env.DATABASE_URL, max: 3 });

// Como máximo 5 llamadas simultáneas al proveedor externo
const partnerLimit = pLimit(5);

export function callPartner<T>(fn: () => Promise<T>) {
  return partnerLimit(fn);
}

export async function generateReport(userId: string) {
  const client = await reportsPool.connect();
  try {
    const { rows } = await client.query('SELECT ... WHERE user_id = $1', [userId]);
    return buildPdf(rows);
  } finally {
    client.release();
  }
}
Los valores de max y del límite son de ejemplo. Los reales dependen de cuántas conexiones aguanta tu base de datos y de cuántas instancias tienes corriendo, porque cada instancia abre su propio pool.
Si los reportes de verdad son pesados, lo mejor es sacarlos del proceso de la API. Una cola como BullMQ con un worker separado hace que la API solo encole el trabajo y responda rápido.
Cómo se combina con lo anterior
Con timeout y circuit breaker controlas cuánto esperas y cuándo dejas de insistir. El bulkhead le pone un techo a cuántos recursos puede ocupar una parte lenta. Si el proveedor de reportes se pone lento, en el peor caso se llenan sus 5 espacios y el resto del sistema sigue igual.
Errores comunes
- Separar todo desde el día uno. Más pools significa más configuración y recursos que a veces quedan sin usar. Conviene empezar separando solo lo crítico de lo pesado.
- Olvidar que el límite total de conexiones de la base de datos es la suma de todos los pools de todas las instancias.
- Poner un límite de concurrencia sin timeout. Las tareas que esperan su turno también deberían tener un límite.
5. Health checks y graceful shutdown
Por qué importa
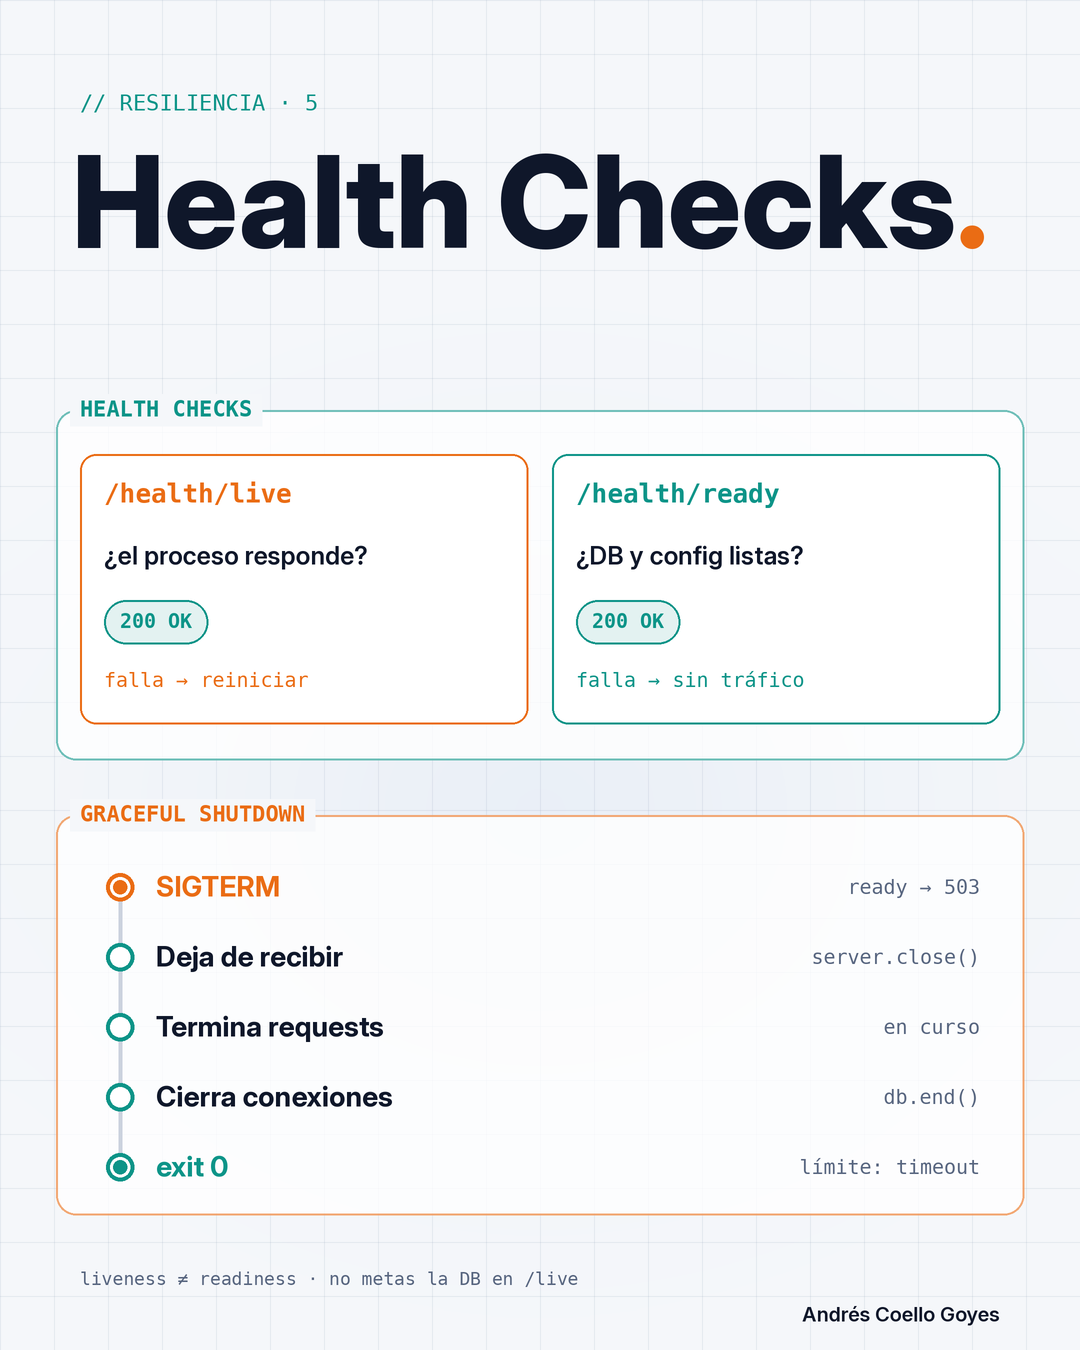
Haces un deploy. La nueva instancia arranca, el load balancer le manda tráfico de inmediato y los primeros usuarios reciben errores, porque el servicio todavía no terminaba de conectarse a la base de datos. Al mismo tiempo, la instancia vieja se apaga de golpe con requests a medio procesar.
Los dos problemas aparecen justo en el momento en que más cosas están cambiando, y los dos tienen arreglo.
Liveness y readiness
Lo normal es tener dos endpoints que responden preguntas distintas.
/health/live dice si el proceso está vivo y puede responder. Si falla, el orquestador lo reinicia.
/health/ready dice si está listo para recibir tráfico, o sea que ya se conectó a la base de datos y cargó su configuración. Mientras devuelva error, el load balancer no le manda requests.
Ya hablé del load balancer en LinkedIn, y esto es lo que le permite saber a qué instancia mandar cada request.
Graceful shutdown
Cuando la plataforma quiere apagar una instancia, sea en un deploy o al escalar hacia abajo, le manda SIGTERM. Ahí el servicio debería marcarse como no listo, dejar de aceptar requests nuevas, terminar las que tiene en curso, cerrar conexiones y recién ahí salir. Todo con un límite de tiempo, porque si algo se queda colgado la plataforma termina mandando SIGKILL.
Ejemplo
import express from 'express';

const app = express();
let ready = false;
let shuttingDown = false;

app.get('/health/live', (_req, res) => res.status(200).send('ok'));

app.get('/health/ready', (_req, res) => {
  if (!ready || shuttingDown) return res.status(503).send('not ready');
  res.status(200).send('ready');
});

const server = app.listen(process.env.PORT ?? 3000);

async function start() {
  await mainPool.query('SELECT 1');
  ready = true;
}

process.on('SIGTERM', () => {
  shuttingDown = true;

  server.close(async () => {
    await mainPool.end();
    await reportsPool.end();
    process.exit(0);
  });

  setTimeout(() => process.exit(1), 10_000).unref();
});

start().catch((err) => {
  logger.error({ err }, 'no se pudo iniciar');
  process.exit(1);
});
server.close deja de aceptar conexiones nuevas y espera a que terminen las abiertas. El setTimeout es el límite para no esperar para siempre, la misma idea de la sección de timeouts. El unref() evita que ese timer por sí solo mantenga vivo el proceso.
Un detalle con conexiones keep-alive es que pueden quedarse abiertas aunque no tengan requests en curso. Desde Node.js 18.2 existe server.closeIdleConnections() para cerrarlas, y conviene llamarlo después de server.close.
Errores comunes
- Meter la base de datos en el liveness. Si la base se pone lenta, todas las instancias fallan el check y se reinician a la vez, y el problema crece.
- Un readiness que siempre responde 200 aunque el servicio no pueda trabajar.
- Correr la app con un script que no le pasa la señal al proceso de Node, por ejemplo
npm startdentro de un contenedor sin un init adecuado. ElSIGTERMnunca llega y el proceso muere conSIGKILL. - Un tiempo de gracia de la plataforma más corto que el tiempo que tu app necesita para cerrar.
Cómo encajan todos en una request
Por separado cada patrón parece una mejora pequeña. Donde se nota el valor es cuando una misma request pasa por varios de ellos.
Toma la página de producto de una tienda.
- El load balancer solo manda la request a instancias que responden bien en
/health/ready. - La API consulta el producto y el precio usando el pool principal, con timeout.
- Pide recomendaciones con un timeout corto. Si el circuit breaker está abierto o la llamada falla, responde con el fallback de caché.
- Revisa los kill switches. Si reseñas o stock en vivo están apagados por carga, devuelve esas secciones en modo degradado.
- Si el usuario pide un reporte desde ahí, la API lo encola y el worker lo procesa con su propio pool limitado.
- Si en medio de todo llega un deploy, la instancia vieja deja de estar lista, termina esta request y se apaga limpio.
El mismo recorrido, visto como flujo:
- Usuario → load balancer → API, solo si
/health/readyresponde bien. - API → base de datos, con pool principal y timeout.
- API → recomendaciones, con timeout y circuit breaker. Si fallan, caché de más vendidos.
- API → reseñas y stock en vivo, detrás de un kill switch. Si está apagado, respuesta degradada.
- API → cola de reportes → worker, con pool limitado. Fallos repetidos → DLQ.
Lo que me gusta de verlo así es que ninguno de los patrones es complicado por sí solo. La resiliencia sale de combinarlos y de decidir con tiempo qué hace el sistema cuando algo falla.
Por dónde empezar
Si tu backend hoy no tiene nada de esto, no hace falta aplicarlo todo de una vez. El orden que yo seguiría es este.
- Timeouts en todas las llamadas externas y en la base de datos.
- Health checks separados y manejo de
SIGTERM, porque se nota en cada deploy. - Fallback en las secciones secundarias que hoy rompen páginas completas.
- Bulkhead para el trabajo pesado que comparte recursos con lo crítico.
- La lista de esencial y opcional, con kill switches probados.
Con eso cierro la serie de resiliencia. El siguiente bloque en LinkedIn es sobre datos, y empieza con caching.
Si aplicaste alguno de estos patrones y te encontraste con un problema que no mencioné, me interesa saberlo. Me puedes escribir por LinkedIn o desde el formulario de contacto del sitio.