Cuando las apps entienden lo que preguntas: embeddings, LLMs y Qdrant
De keywords a significado: cómo embeddings + LLM + Qdrant forman un RAG, por qué no rivalizan con la búsqueda tradicional, y cómo un asistente automotriz responde sin inventar.
El problema no es el chatbot
Casi cualquiera puede conectar un LLM y obtener respuestas fluidas.
El problema de verdad aparece después:
¿La respuesta viene de tu conocimiento… o de la imaginación del modelo?
En TsáchilTalks #021 (GDG Tsáchilas) compartí cómo armar un stack que entiende intención y responde con contexto real: embeddings, búsqueda semántica, LLMs y Qdrant como base vectorial — es decir, un RAG.
También puedes ver el resumen en video en este sitio.
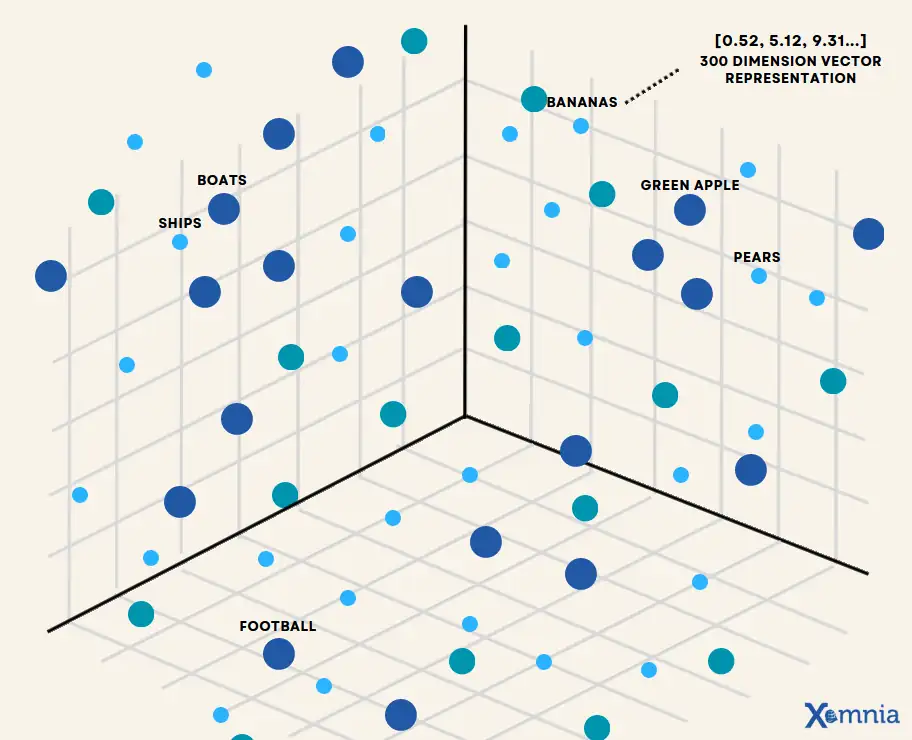
Embeddings: el mapa del significado
Un embedding convierte texto en un vector. No “guarda la frase”; guarda dónde vive esa idea en un espacio semántico.
Ahí pasa algo poderoso:
- “filtro de aceite Aveo 2015” y “qué rosca usa el filtro del Aveo Family” pueden acercarse aunque no compartan las mismas palabras.
- Manuales técnicos y preguntas de clientes empiezan a hablar el mismo idioma: el de la cercanía.
Explico la intuición matemática (distancias, similitud) y una visión bidimensional: palabras y conceptos cerca o lejos según significado, no según coincidencia de strings.
Tradicional vs semántica (no es pelea)
Hay un mito: “la búsqueda semántica reemplaza a la tradicional”.
No. Se usan en momentos distintos.
- Tradicional (keywords, filtros, SKUs, SQL): gana cuando necesitas exactitud y control.
- Semántica (embeddings): gana cuando el humano pregunta como humano.
Un buen producto mezcla ambas. Exactitud donde duele equivocarse; significado donde duele no entender al usuario.
Qdrant no es “una columna de vectores”
Muchas bases mixtas pueden almacenar embeddings. Qdrant está diseñada para ser vectorial de verdad: indexar, buscar y recuperar por similitud como operación central.
En un RAG el flujo es claro:
- Partes documentos (manuales, fichas, FAQs).
- Generas embeddings.
- Indexas en Qdrant.
- Ante una pregunta, recuperas los fragmentos más cercanos.
- El LLM responde solo con ese contexto (grounding).
Sin ese paso, tienes un chat elocuente. Con ese paso, tienes un asistente confiable.
Caso real: asistente automotriz
Imagina un comercio de repuestos. Decenas de personas preguntan:
- ¿Qué comprar?
- ¿Cómo se usa?
- ¿Cómo se instala?
Atender todo a mano no escala. Un asistente con este stack puede ayudar con el conocimiento del negocio, no con inventos de internet.
Eso es lo que conecta con la experiencia en Tayos: RAG sobre documentación técnica automotriz, workers, Qdrant y Gemini — respuestas grounded, no alucinadas.
Qué me llevo (y qué puedes llevarte tú)
- Embeddings = mapa del significado.
- Semántica y keywords = aliados, no rivales.
- Qdrant = vector DB hecha para buscar por cercanía.
- RAG = LLM + contexto recuperado = respuestas útiles y honestas.
Si estás construyendo IA en producto (no solo demos), esta charla es el puente entre “probar un modelo” y “entender lo que el usuario quiere decir”.
Mira la charla completa: Embeddings y Búsqueda Semántica con LLMs y Qdrant | TsáchilTalks #021